LabVIEW로 프로그램을 개발하다 보면 이런 생각이 들 수 있습니다.
“지금 사용하는 구조로도 충분히 만들 수 있는데, 굳이 객체지향 프로그래밍을 배워야 할까?”
맞습니다. 사실 LabVIEW에서 주로 개발하는 계측 및 제어 시스템은 사실 복잡할 게 없습니다.
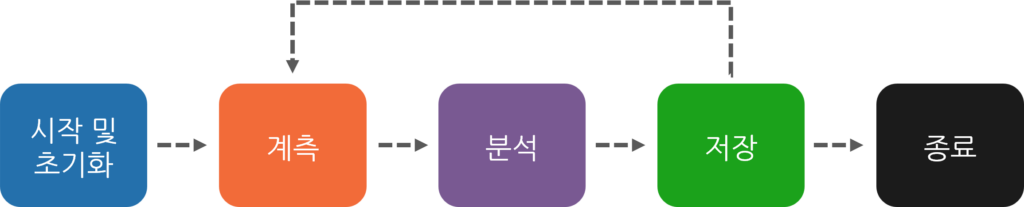
대부분의 계측 시스템은 위 순서도처럼 시스템 시작 이후 계측, 분석, 저장만 반복하다가 종료하는 게 다입니다.
그래서 기존에 익숙한 방식으로 충분히 프로그램을 빠르게 완성할 수 있습니다.
하지만 최근 계측 및 제어시스템 달라졌습니다. 시스템에서 사용하는 하드웨어의 종류와 숫자도 많아지고
사용자의 요구사항도 점점 더 디테일해지며 복잡해지기 시작했습니다.
스마트폰 앱과 AI 서비스 등 다양한 소프트웨어를 경험하면서, 사용자들이 프로그램에 기대하는 편의성과
기능 수준도 높아졌습니다. 계측 및 제어 프로그램에도 더 세밀한 설정과 다양한 부가 기능을 요구하게 된 것입니다.
그래서 높아진 요구사항에 맞추어 기능을 하나 둘씩 개발하면 엄청 복잡해진 블록다이어그램을 접하게 됩니다.
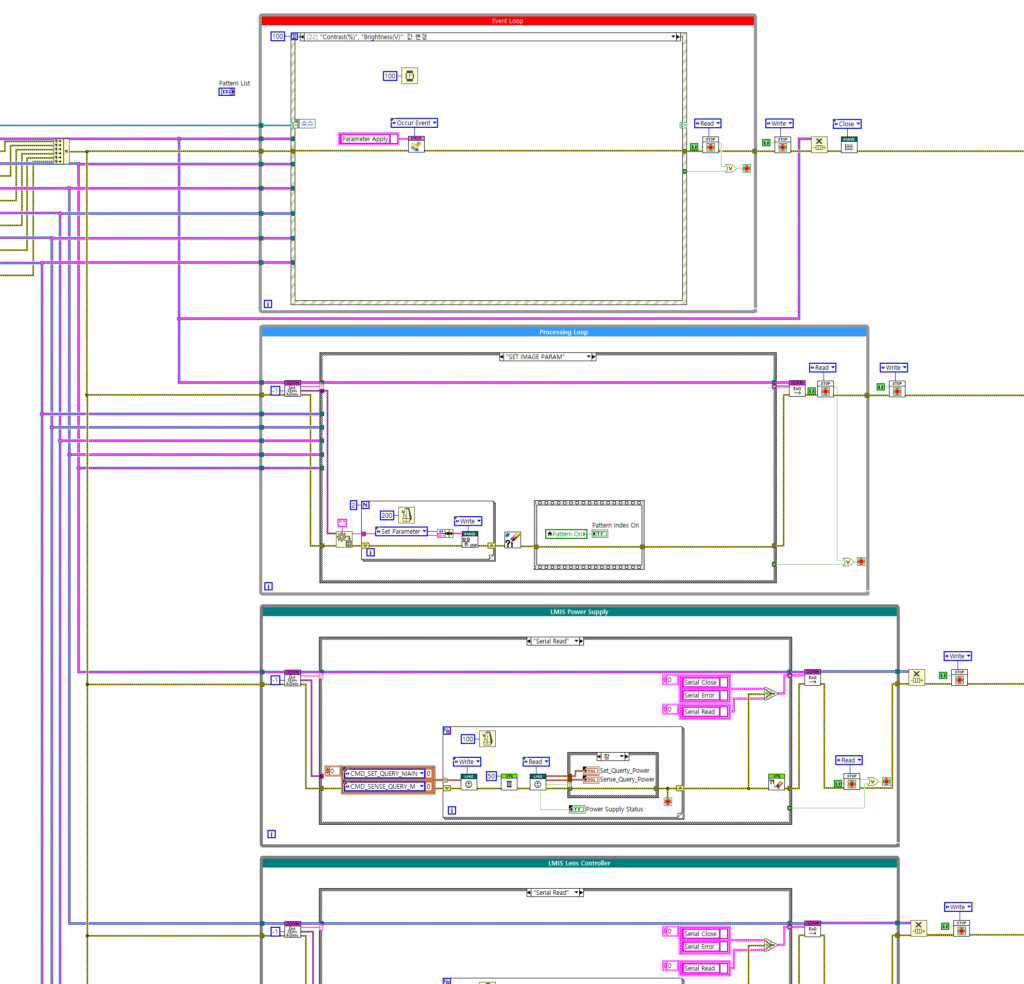
위 이미지는 충분히 잘 만들어진 다이어그램이지만 많은 수의 하드웨어 제어와 요구사항으로 인해 소스코드가 복잡해진 상태입니다.
SubVI와 FGV(Functional Global Variable)로 기능과 데이터를 정리하더라도, 기능 사이의 의존 관계가 많아지면 수정의 영향 범위를 파악하기 어려워집니다.
특히 오랫동안 사용되는 소프트웨어인 경우 유지 및 보수, 확장에 있어서 위와 같은 소스코드를 관리하기는 쉽지 않습니다.
이처럼 프로그램은 처음 빠르게 만드는 것만큼, 이후의 유지보수와 확장을 쉽게 만드는 것이 중요합니다.
객체지향 프로그래밍(OOP, Object-Oriented Programming)은 이러한 변경을 관리하기 위한 설계 방법입니다.
관련된 데이터와 기능을 하나로 묶고, 각 객체의 책임과 외부에서 사용하는 기능을 구분하여 프로그램을 구성합니다.
LabVIEW에서는 클래스의 캡슐화, 상속, 동적 디스패치 등을 활용해 공통 기능을 재사용하고, 달라지는 부분을 분리할 수 있습니다.
역할과 경계를 잘 설계하면 기존 코드에 미치는 영향을 줄이면서 기능을 추가하거나 수정하기가 수월해집니다.
물론 객체지향을 사용한다고 유지보수가 저절로 쉬워지는 것은 아닙니다.
앞으로 객체지향의 주요 개념을 하나씩 살펴보며, 변경과 확장에 대응하기 쉬운 LabVIEW 프로그램을 만드는 방법을 알아보겠습니다.